
知识库
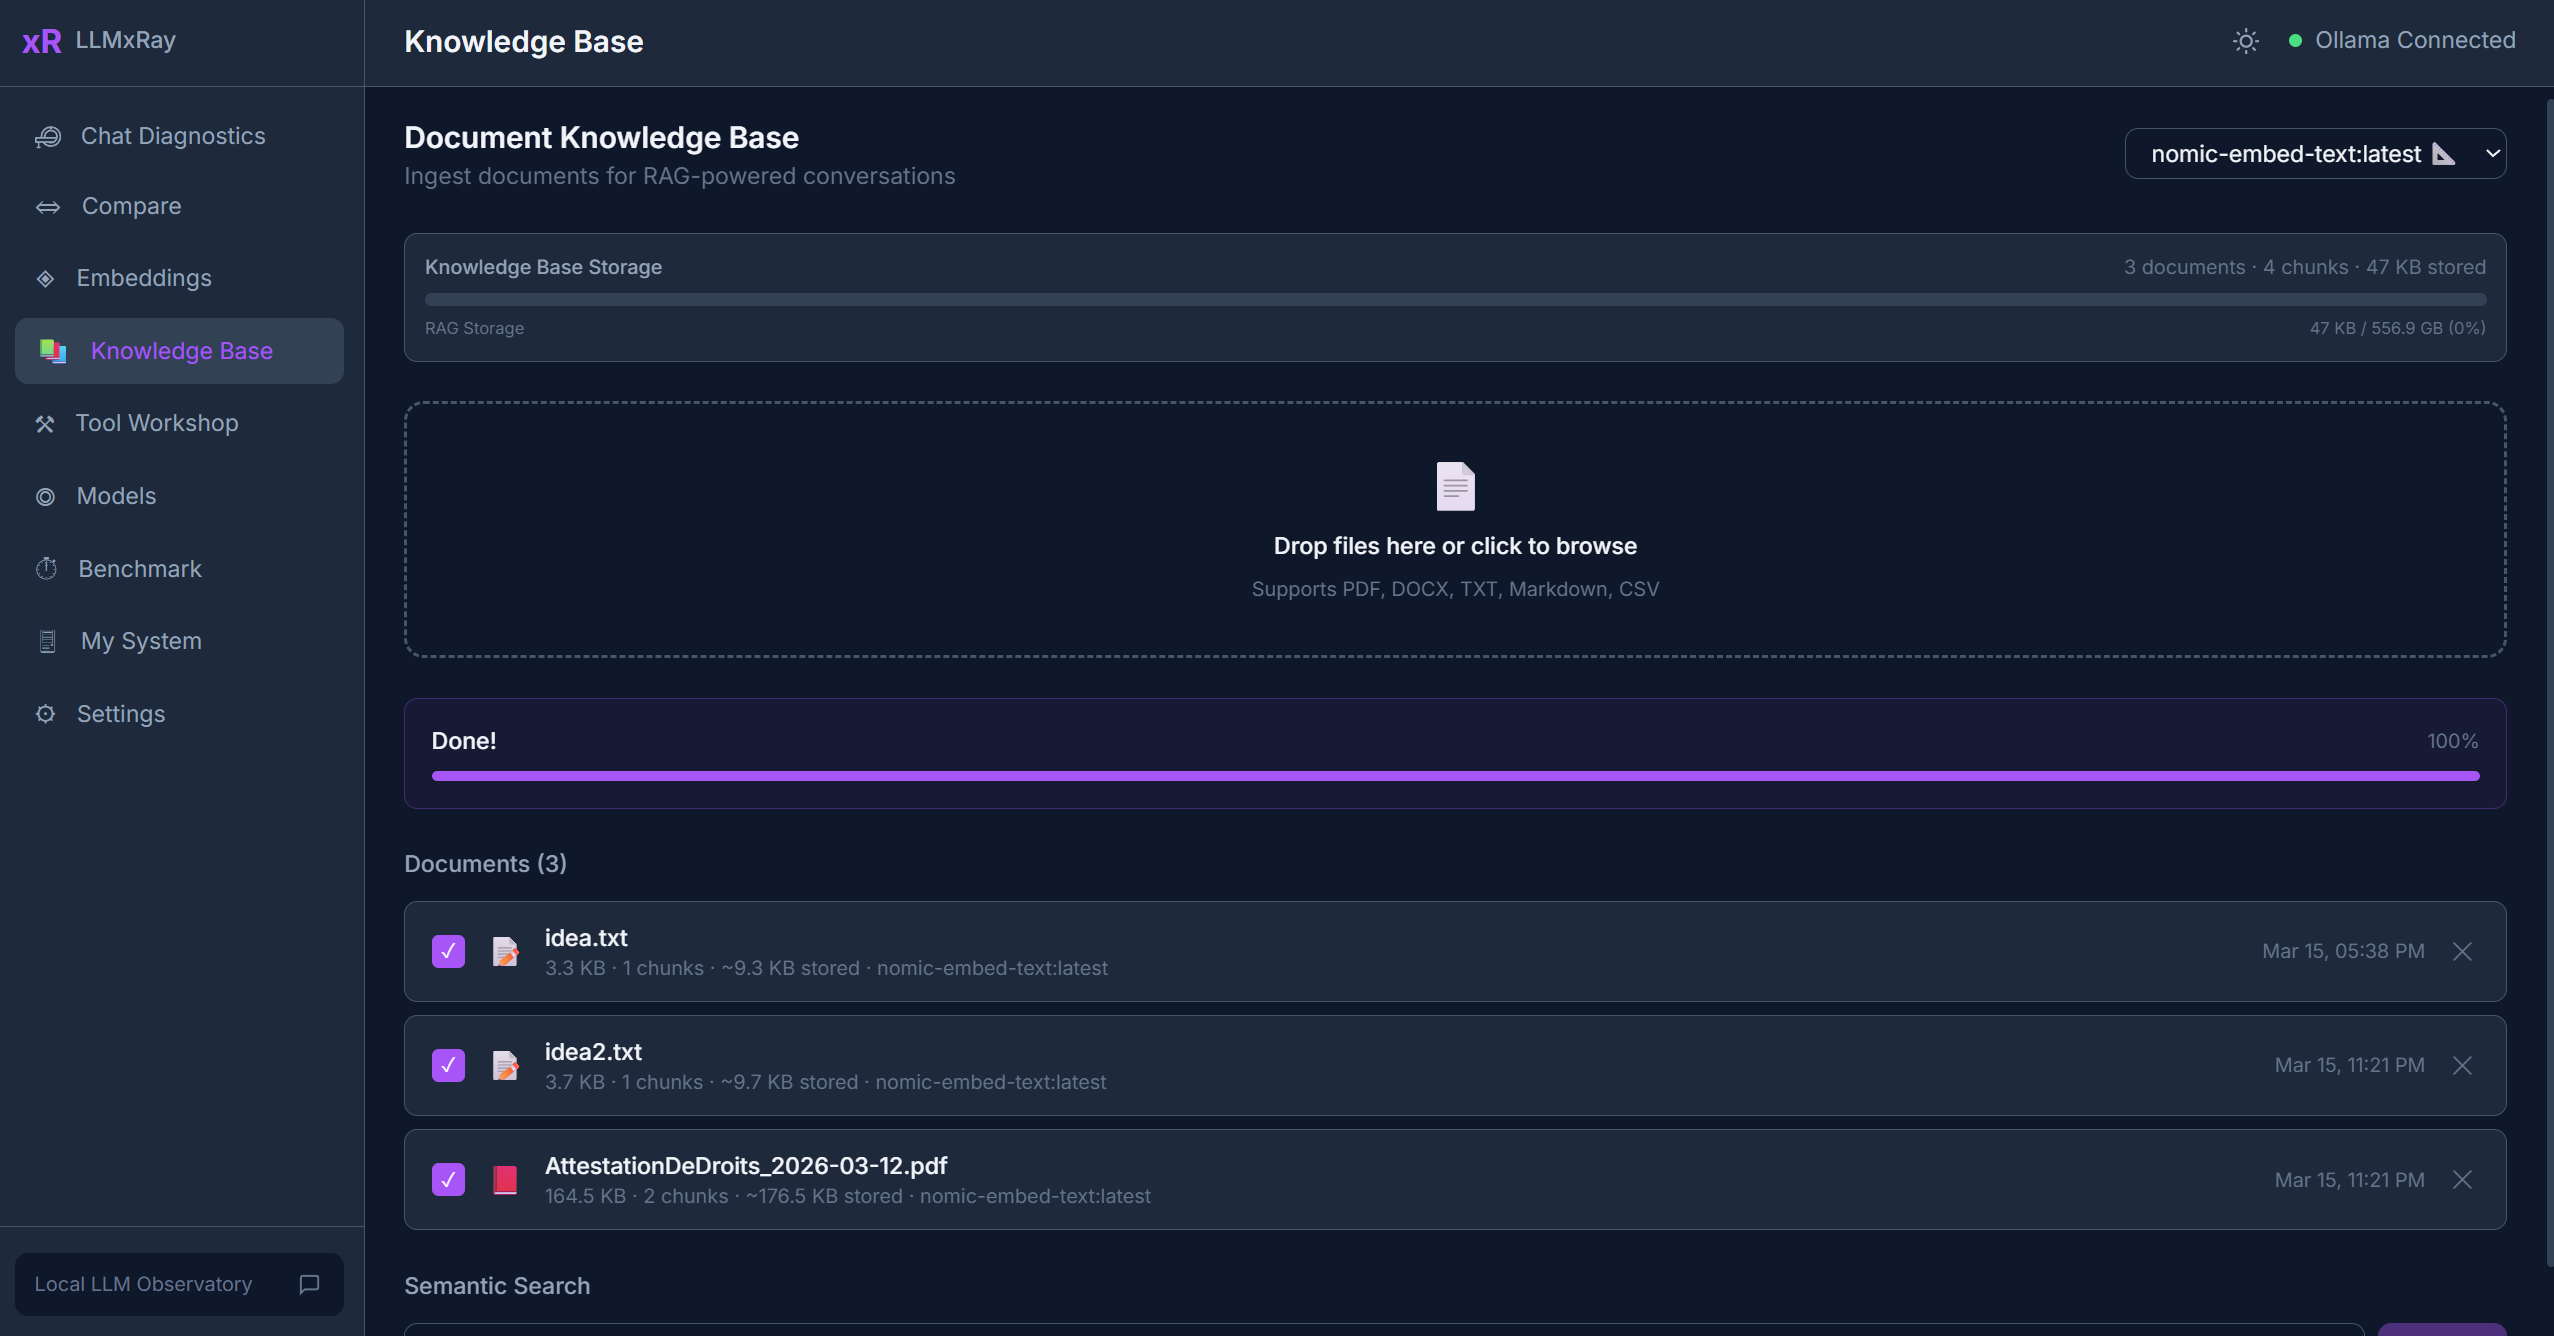
知识库页实现了一条完整的本地 RAG(检索增强生成)流水线。上传你的文档、生成嵌入、用自然语言检索 —— 全部存放在你的浏览器里。
侧边栏位置: 知识库 路由: /rag
什么是 RAG?
RAG 是 Retrieval-Augmented Generation(检索增强生成)的缩写。它不再只依赖模型训练时学到的内容,而是把你自己文档中的相关片段喂给模型。模型随后以这些片段为上下文,给出更准确、更有依据的回答。
上传文档
点击上传并选择一个或多个文件。支持的格式:
| 格式 | 扩展名 | 解析器 |
|---|---|---|
.pdf | pdfjs-dist(按需加载) | |
| Word | .docx | mammoth |
| 纯文本 | .txt、.md | 原生 |
| CSV | .csv | papaparse |
处理流水线
上传之后,每个文档会经过三个阶段:
- 解析 —— 从文件格式中提取原始文本
- 切分 —— 把文本切成互相重叠的片段(大小与重叠量可配置)
- 嵌入 —— 用你选择的嵌入模型为每个片段生成向量
进度会按文档分别显示。完成后,文档状态会变为「就绪」。
检索
- 在搜索栏中输入自然语言查询。
- 结果按余弦相似度排序,语义上最相关的片段排在最前。
- 每条结果显示:
- 匹配到的文本片段
- 来源文档名称
- 相似度分数
- 元数据(页码、章节、字符偏移量)
管理文档
- 启用 / 停用 —— 控制文档是否参与检索。停用的文档不会出现在结果中。
- 删除 —— 从 IndexedDB 中移除文档及其全部片段。
- 状态指示 —— 显示处理阶段(解析中、切分中、嵌入中、就绪、出错)。
存储
一切都存放在浏览器内置的数据库 IndexedDB 中:
- 零成本 —— 不需要任何外部服务
- 零配置 —— 开箱即用
- 数据留在你自己的机器上
- 刷新浏览器不会丢失(但清除浏览器数据会)
与对话的结合
当知识库中有文档时,相关片段可以自动作为上下文加入你的对话,让模型的回答建立在你自己的数据之上。
小贴士
- 较小的片段(200–400 token)通常能得到更精准的检索结果。
- 嵌入模型很重要 —— 对英文文本,
nomic-embed-text通常表现不错。 - 大型 PDF 需要一些处理时间。界面会显示进度,方便你跟踪流水线。
- 你可以上传多个文档,并同时在所有文档中检索。