嵌入
嵌入页让你生成文本嵌入,并直观地比较两段文字在语义上有多相似。
侧边栏位置: 嵌入 路由: /embeddings
什么是嵌入?
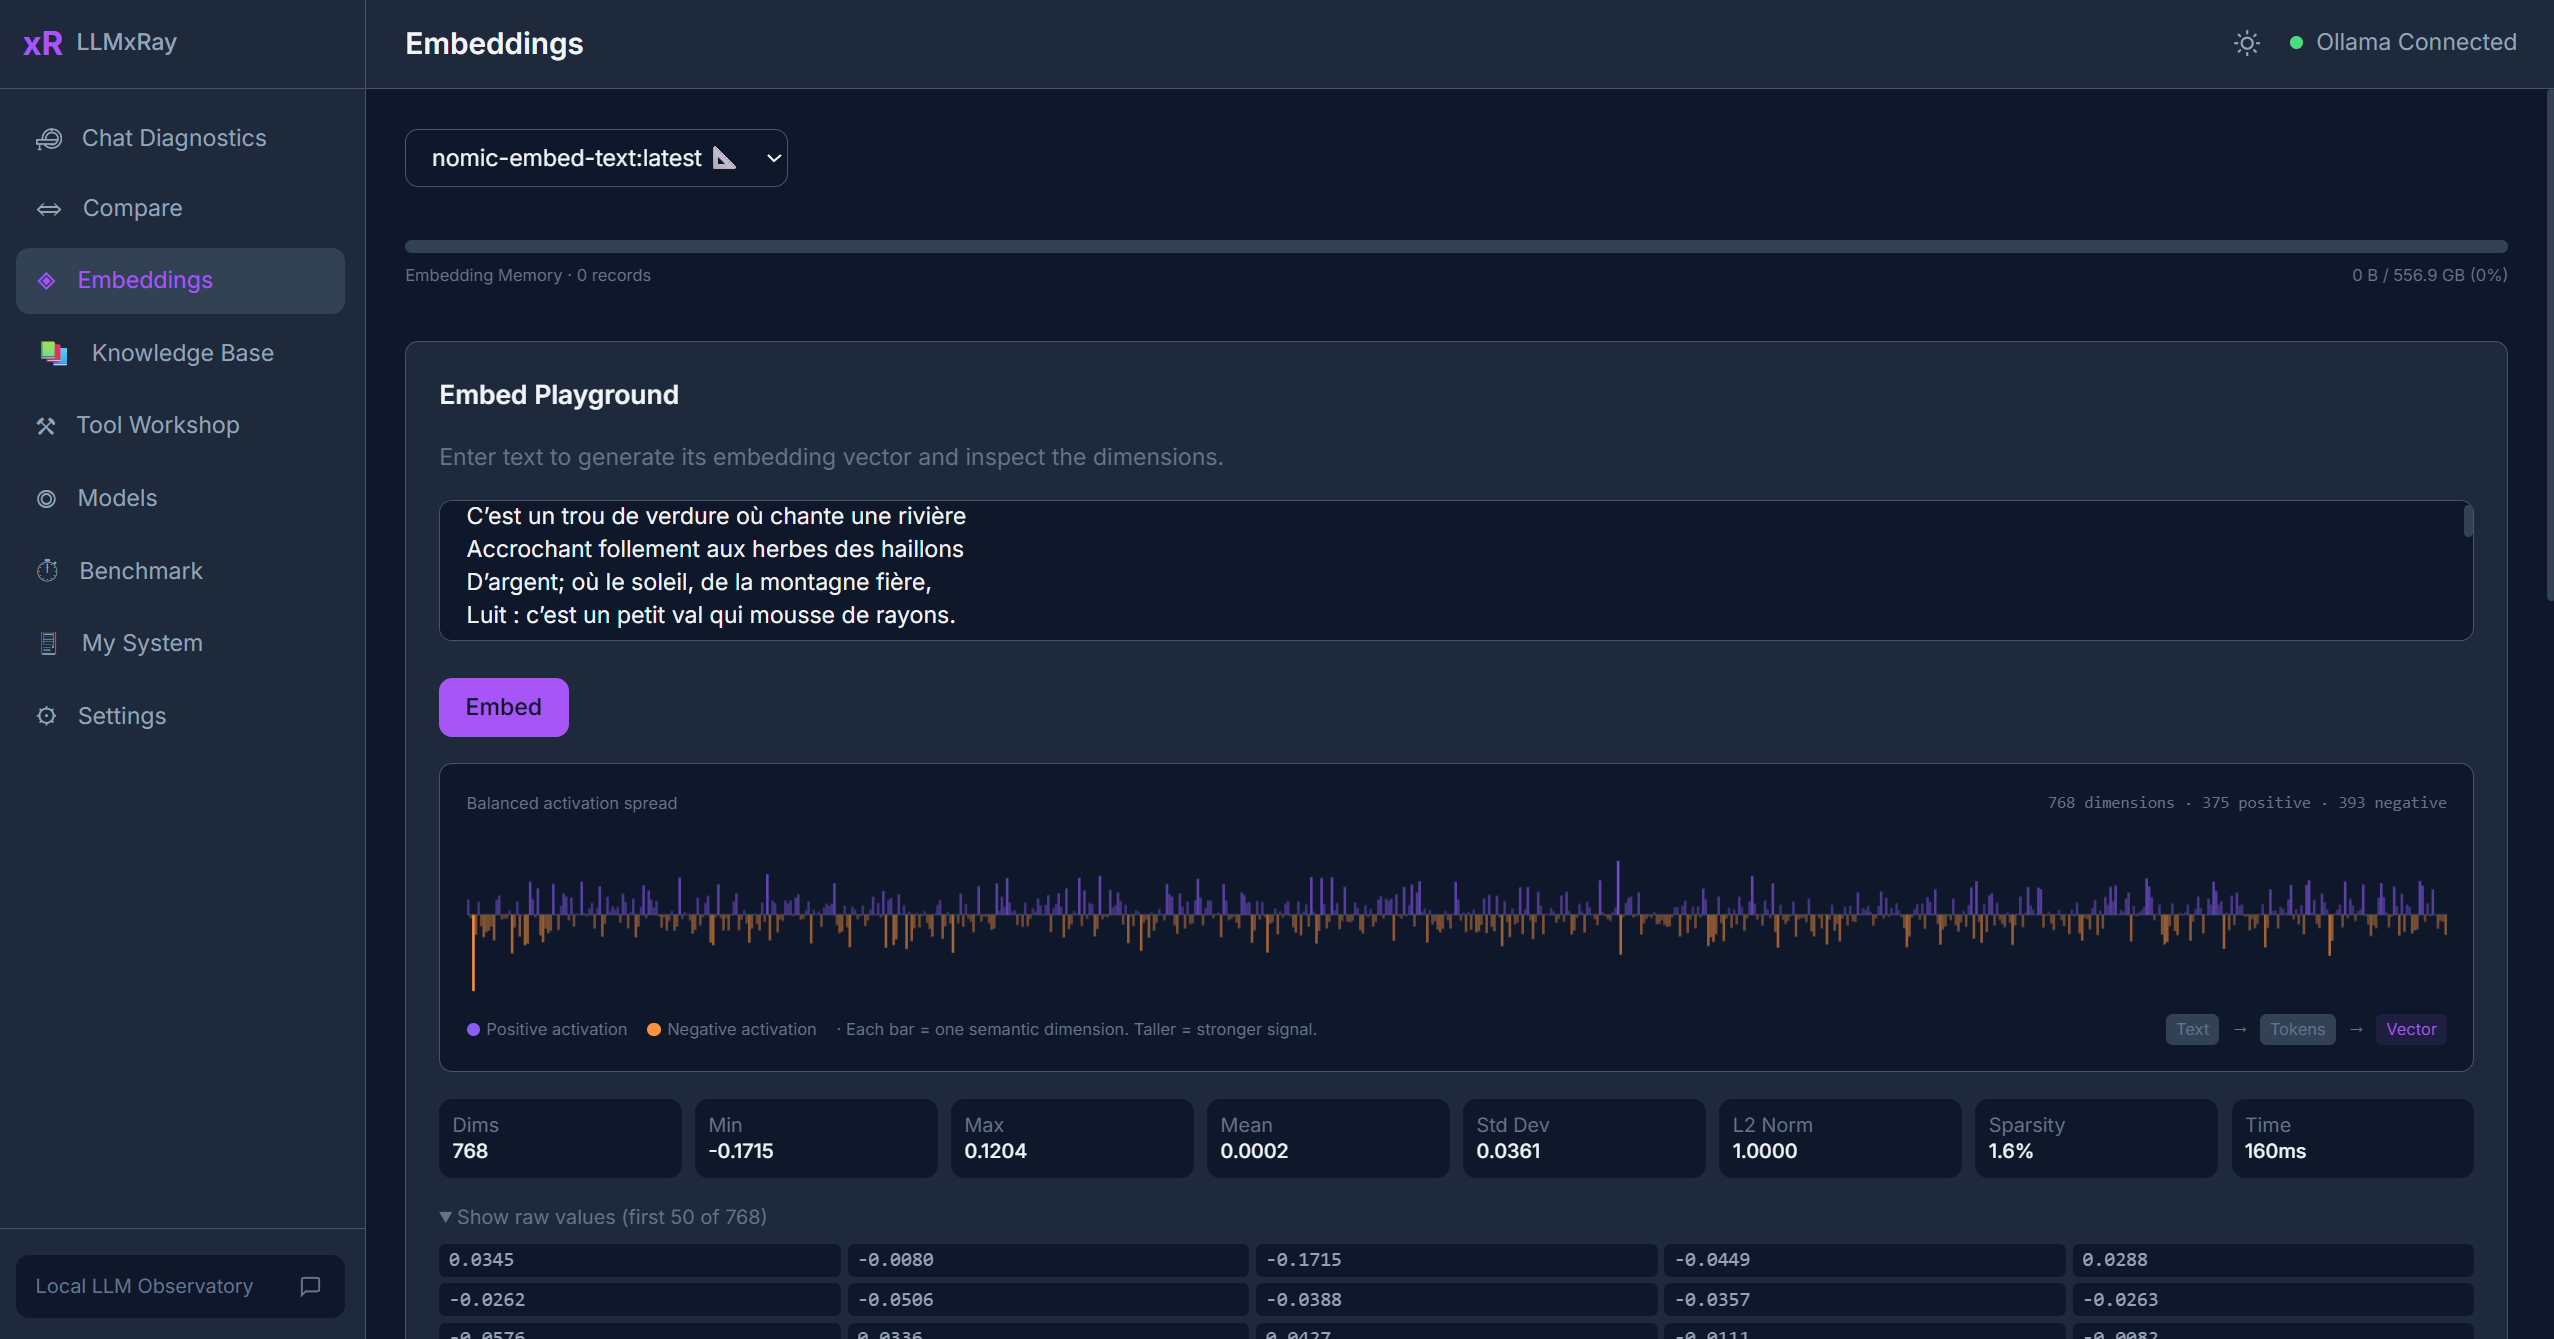
嵌入是一串数字(一个向量),用来表示一段文字的含义。含义相近的文字,会产生方向相近的向量。LLMxRay 利用这个概念,让你可以动手探索语义相似度。
为文本生成嵌入
- 从下拉框中选择一个嵌入模型。只有具备嵌入能力的模型才会出现(例如
nomic-embed-text、all-minilm)。 - 在输入区输入文字。
- 点击生成嵌入。结果向量会以柱状图的形式可视化显示。
没有嵌入模型?
如果下拉框里什么都没有,说明你需要先拉取一个:
bash
ollama pull nomic-embed-text比较两段文字
- 在两个输入区分别输入文字。
- 点击比较。两段文字都会被嵌入并进行比较。
- 余弦相似度指示器会显示两段文字在语义上有多接近:
- 1.0 —— 含义完全相同
- 0.7 以上 —— 非常相似
- 0.3–0.7 —— 有一定关联
- 低于 0.3 —— 不相关
为图片生成嵌入
自 Ollama 0.40 起,/api/embed 在同时声明 embedding 和 vision 能力的模型上可以接受图片与文本一起输入。所选模型支持时,实验台文本框下方和相似度计算器的两侧都会出现附加图片控件。纯文本模型不会显示任何图片控件,因为守护进程对媒体输入返回 501。
你可以这样用:
- 嵌入一张照片和一句描述它的话,然后比较两者。同一个向量空间,因此余弦相似度是有意义的。
- 比较两张照片。
- 只嵌入一张图片,不带文本。
每个结果都会显示它消耗的提示词 token。图片在文本之外是一块固定的 token:在 embeddinggemma-2 上实测,一句短句消耗 7 个 token,同一句加一张极小的图片消耗 265 个。无论图片多大,这一块都要付。
目前唯一支持此功能的模型 embeddinggemma-2 运行在 Ollama 的 MLX 运行时上,而 MLX 仅存在于 Apple Silicon。 在 Windows 或 Linux 上,ollama pull embeddinggemma-2 会失败并提示 "this model requires MLX support"。要从另一台机器使用它,请通过 SSH 转发 Mac 上的守护进程,并在设置中把 LLMxRay 指向它:
ssh -L 11435:localhost:11434 user@your-mac然后把 Ollama URL 设为 http://localhost:11435/api。
使用场景
- 理解嵌入 —— 看清这些数字究竟代表什么
- 测试 RAG 的相关性 —— 检查你的文档是否能匹配上用户的提问
- 探索近义表达 —— 观察模型如何理解语义关系
- 教学 —— 非常适合 AI/ML 课程中讲解向量表示
小贴士
- 不同的嵌入模型会产生不同的向量维度和相似度分数。
- 简短、聚焦的文字比长段落更能得出有意义的比较结果。
- 结果会保存在会话中,之后可以回看。