
对话诊断
对话诊断页是 LLMxRay 的核心。它把一个功能完整的对话界面,和对模型产出的每一个 token 的深度实时分析结合在一起。
侧边栏位置: 对话诊断(第一项) 路由: /
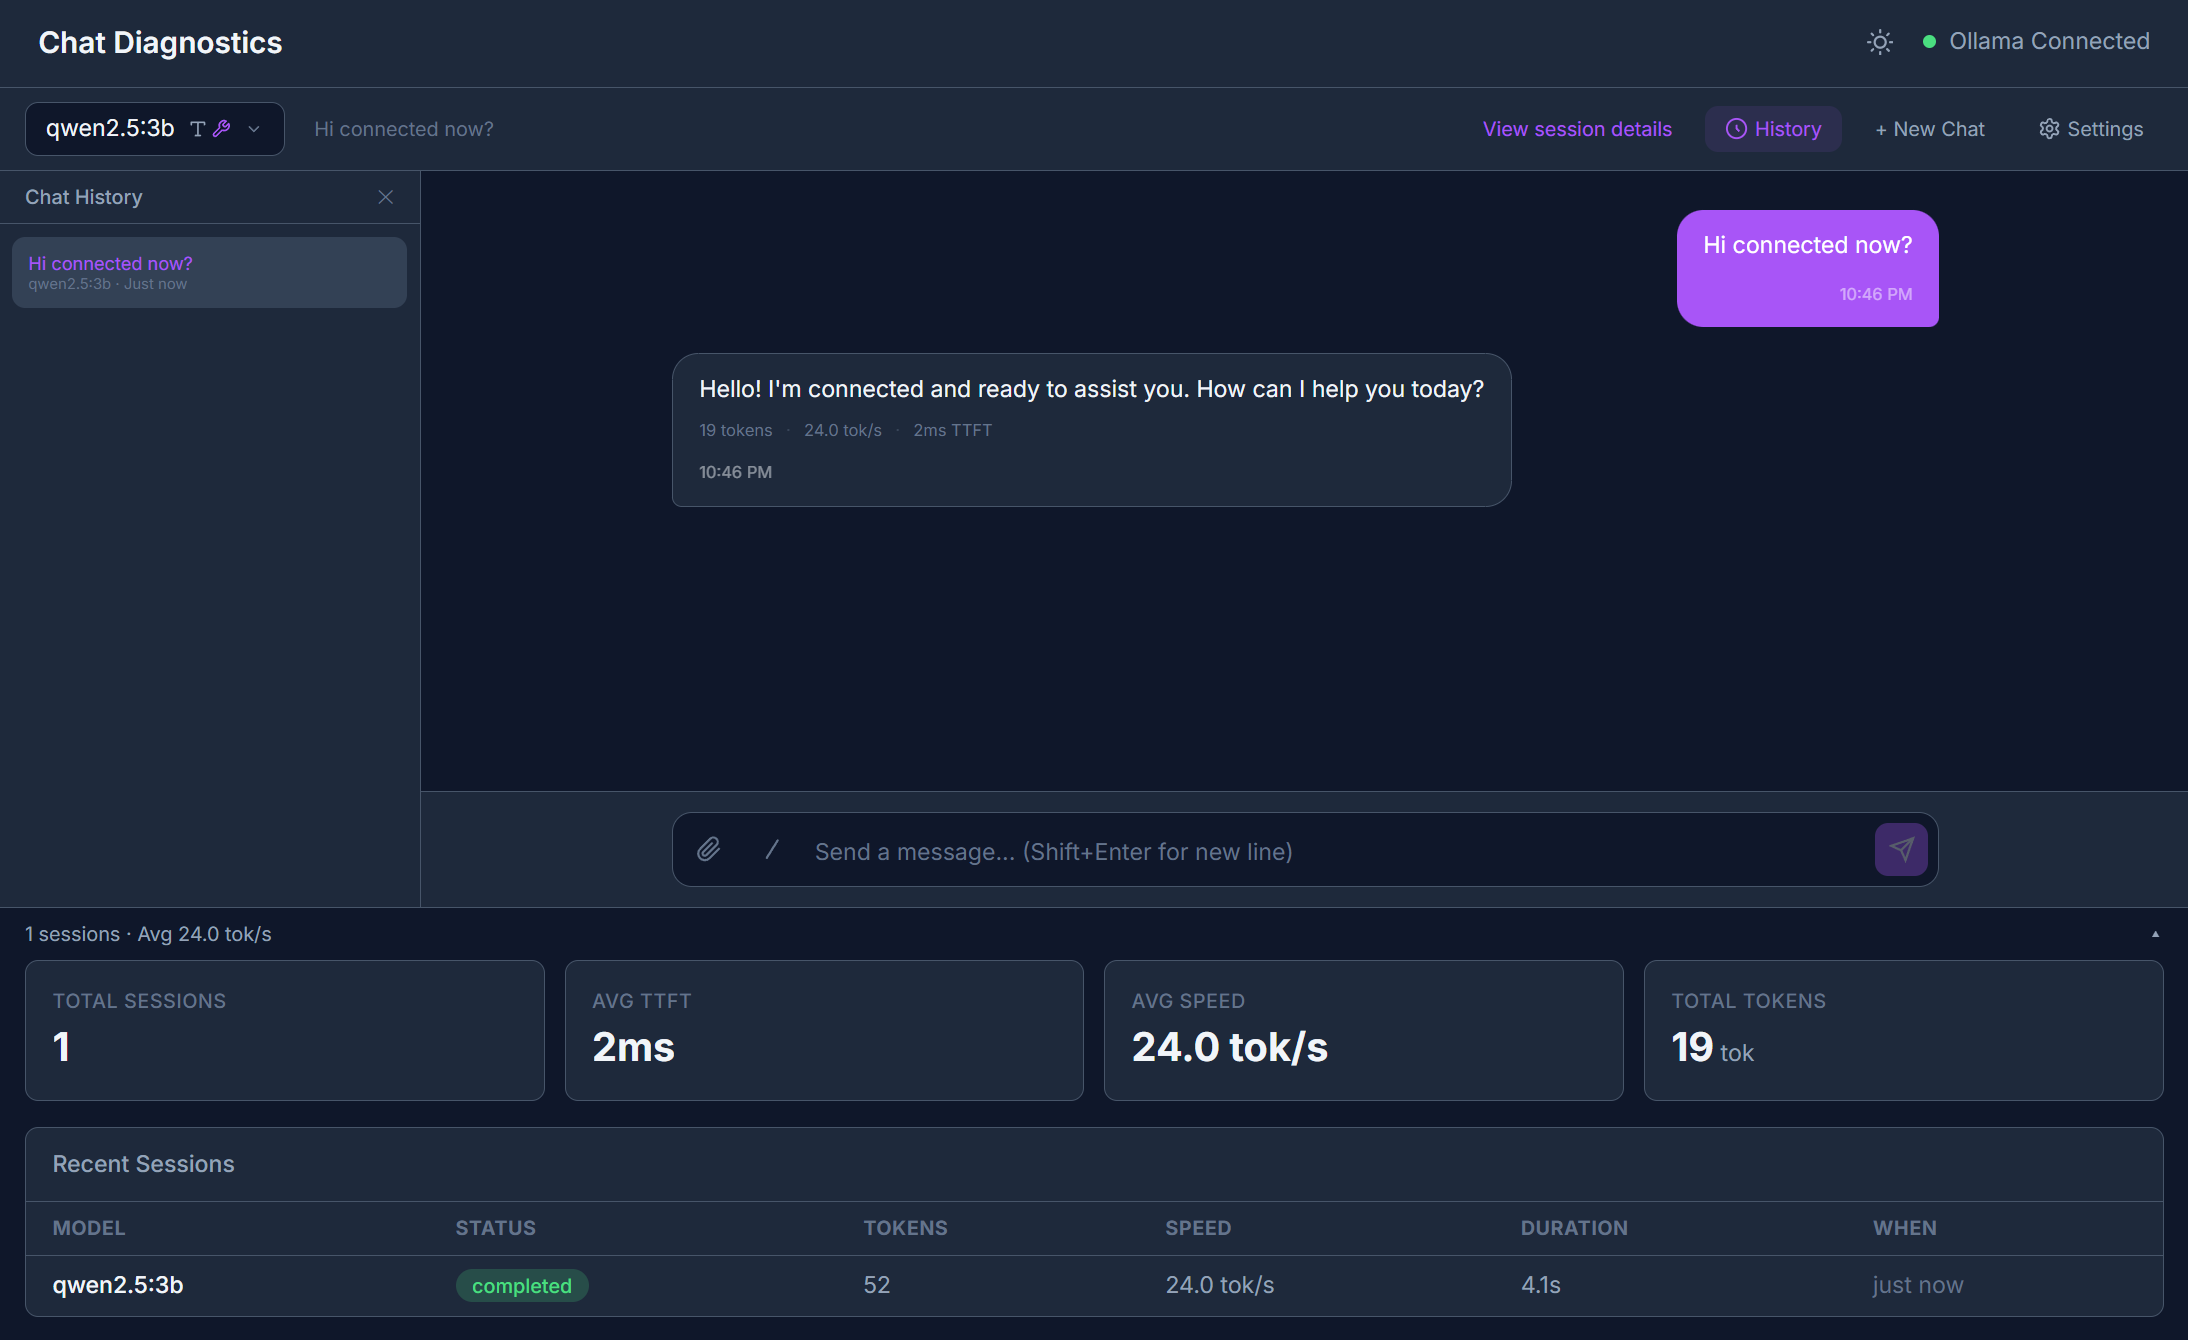
界面概览
页面分为两块:
- 左侧面板 —— 会话列表,显示所有历史对话及其时间戳、模型名称和 token 数量。
- 右侧面板 —— 当前对话区域,包含输入框、流式输出和会话详情标签页。
开始一段对话
- 从顶部的模型下拉框选择一个模型。嵌入模型会被自动过滤掉,只显示可用于对话的模型。
- 在输入区输入你的消息。
- 按 Enter 或点击发送。
Token 会逐个流式到达,并带有置信度着色:每个 token 的颜色取决于模型生成它的速度。越快的 token 置信度越高(偏绿),越慢的 token 置信度越低(偏橙或偏红)。
置信度是一个近似值
由于 Ollama 的 /api/chat 接口不暴露 token 的 logprobs,LLMxRay 用 token 之间的延迟来近似置信度。界面中对此有明确标注。如果需要真实的 logprobs,请使用基准测试功能。
功能
Markdown 渲染
模型回复会渲染为富文本 Markdown,代码块带语法高亮。
文件附件
点击附件按钮上传文件。对于视觉模型(如 LLaVA),你可以直接粘贴或上传图片,模型会对其进行分析。
斜杠命令
在输入框中输入 / 即可查看可用的斜杠命令,用于快速操作。
多轮对话
每段对话都保留完整的消息历史,模型能看到之前的全部消息作为上下文。
推理控制(v0.4.7+)
对于报告了 thinking 能力的模型(DeepSeek-R1、QwQ 等),对话设置面板中会出现一个推理控件,有三种模式:
- 关闭 —— 不发送
think字段,模型表现为普通对话模型 - 开启 —— 在
/api/chat上发送think: true,模型会在回答前产生一段内部推理过程 - 最大 —— 发送
think: "max",请求模型所支持的最大推理预算(Ollama v0.21.3 加入)
推理过程会显示在会话深入分析的推理标签页中。不支持推理的模型不会显示这个控件。
输出格式控制(v0.4.7+)
对话设置面板中的输出格式选择器可以强制结构化输出,共三种模式:
- 自由文本 —— 无约束,默认值
- 合法 JSON(任意结构) —— 发送
format: "json",模型必须返回可解析的 JSON - JSON Schema(严格) —— 把一个完整的 JSON Schema 对象作为
format发送。界面会出现一个文本框供你粘贴任意合法 schema,并在你输入时实时校验 JSON。模型的输出会被严格约束为匹配该 schema。
JSON Schema 模式在强制基准测试答案格式、校验 Agent 的工具输入、以及提取 RAG 引用时特别有用。
回复质量检查
每一条完成的助手回复都会自动经过五个客户端检测器的分析。发现问题时,回复的指标下方会出现彩色小标签:
| 检测器 | 触发条件 | 严重程度 |
|---|---|---|
| 重复 | 重复 4-gram 超过 50% | 失败(红色) |
| 重复 | 重复 4-gram 超过 30% | 警告(黄色) |
| 拒答 | 匹配 8 种常见拒答模式 | 警告 |
| 乱码 | 非 ASCII 字符超过 40%(文本长度 > 20 字符) | 警告 |
| 空回复 | 0 个词 | 失败 |
| 空回复 | 1–9 个词 | 警告 |
| 截断 | 达到 token 上限,或用掉超过 90% 预算却没有干净的结尾 | 警告 |
指标行中还会出现一个彩色小圆点,便于快速扫视。如果全部检查通过,则不额外显示任何内容 —— 没有消息就是好消息。
全部分析都在客户端完成
质量检查在你的浏览器中对显示出来的回复文本即时运行。没有 API 调用,没有外部服务。
会话深入分析
点击左侧面板中的任意会话,可以展开六个分析标签页:
流式标签页
以可滚动列表展示每个 token 及其计时数据。列表上方的指标面板显示:
- TTFT(首 token 时间)—— 模型开始回答所用的时间
- Token/秒 —— 生成速度
- 总 token 数 —— 提示词与生成内容的 token 数量
- 延迟图表 —— token 之间延迟的可视化时间线
推理标签页
如果你运行的是 DeepSeek-R1 这类推理模型,<think> 块会被自动解析并逐步展示。每一个推理步骤会被归类为思考、观察、行动、结论或反思。
内省标签页
层激活、注意力热力图和模型结构的可视化。
示意性数据
这些可视化使用的是合成数据,用于演示真实内省会是什么样子。界面中已明确标注为「示意」。真正的内省需要 Ollama 并不暴露的模型内部数据。
工具标签页
对话过程中模型发起的所有工具调用的时间线,包含:
- 工具名称与参数
- 执行结果
- 耗时
Agent 标签页
一张状态流转图,展示 Agent 式提示词如何经过规划、工具调用和综合等步骤。
提示词标签页
对你的提示词的结构剖析,包含:
- 识别出的各个部分(系统、用户、上下文、工具、示例)
- 每个部分的 token 数量
- 整体结构分析
小贴士
- 会话持久化 —— 所有对话都存储在 IndexedDB 中,刷新浏览器也不会丢失。
- 中途切换模型 —— 你可以在会话进行中切换模型,新模型会看到完整的对话历史。
- 性能 —— token 存储使用
shallowRef,以保证在数千个 token 时依然流畅。