
基准测试
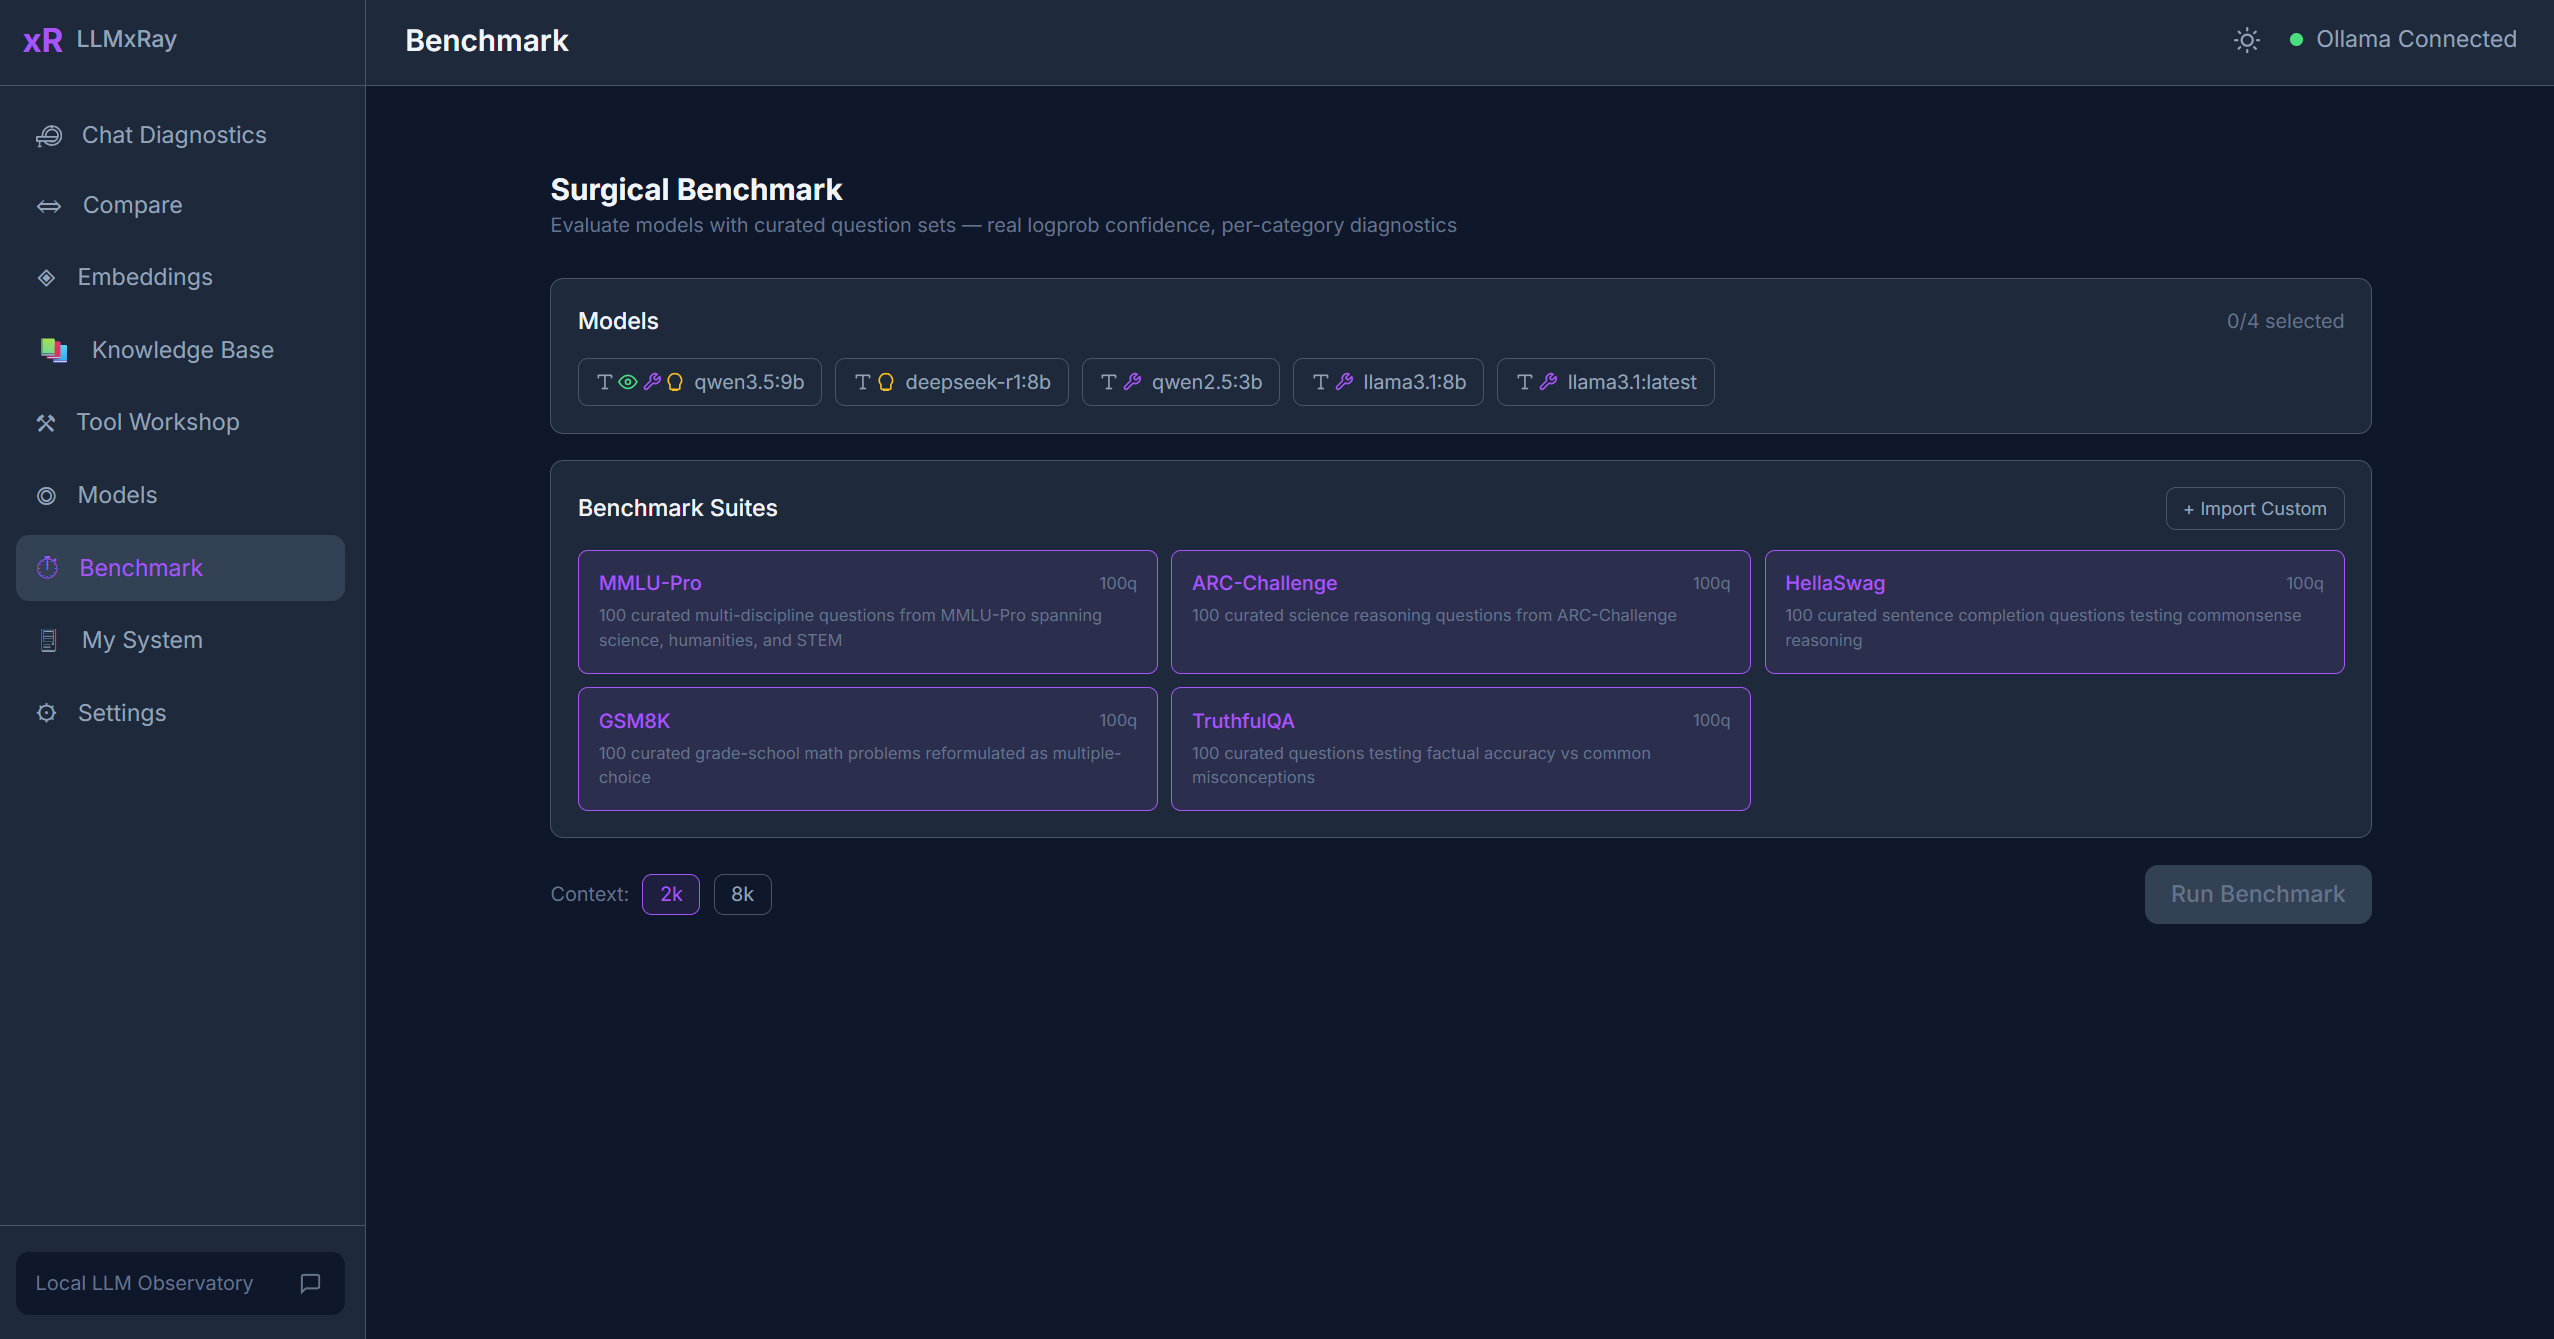
基准测试页使用真实的 token logprobs 对你的本地模型进行标准化评测,给出客观的性能数据。
侧边栏位置: 基准测试 路由: /benchmark
什么是「精准基准测试」?
普通的基准测试只检查答案对不对,而 LLMxRay 的精准基准测试会通过 Ollama 的 OpenAI 兼容接口(/v1/chat/completions)捕获真实的 token logprobs。这样你拿到的不只是准确率,而是每个答案背后真实的置信度数据。
内置测试集
| 测试集 | 题目类型 | 考察什么 |
|---|---|---|
| ARC | 科学推理 | 中小学科学题 |
| GSM8K | 数学应用题 | 多步算术推理 |
| HellaSwag | 句子补全 | 常识推理 |
| MMLU-Pro | 多学科 | 跨领域的广泛学术知识 |
| TruthfulQA | 真实性 | 对常见误解的抵抗力 |
运行一次基准测试
- 从下拉框选择一个模型。
- 勾选一个或多个测试集。
- 点击运行。结果会实时流式呈现。
运行过程中你可以看到:
- 实时进度 —— 已答题数、当前准确率
- 逐题结果 —— 正确 / 错误、模型的答案、置信度分数
- 延迟数据 —— 每题的 TTFT 与 token/秒
推理模型
对于 DeepSeek-R1 这类推理模型,基准测试会使用动态 token 预算 —— 允许模型为 <think> 块使用更多 token,且不计入答案部分。这样推理模型不会因为「把思考过程写出来」而被扣分。
结果可视化
完成后,结果以如下形式呈现:
- 准确率分数 —— 总体正确百分比
- 分类别细分 —— 各测试集内按学科划分的准确率
- 雷达图 —— 跨类别的可视化对比
- 置信度分布 —— 基于 logprob 的置信度分数直方图
对比结果
在多个模型上运行同一个测试集,可以比较:
- 哪个模型在哪些学科上更准确
- 置信度校准 —— 高置信度是否真的对应正确答案?
- 速度与准确率之间的取舍
结果存储在 IndexedDB 中,因此可以跨会话对比。
自定义测试集
点击导入可加载自定义测试集。期望的格式是一个 JSON 文件,包含:
- 测试集名称与描述
- 题目数组,每题包含:题干、选项、正确答案索引,以及可选的类别
你也可以直接在应用内用测试集构建器创建自定义测试集 —— 手动添加题目,或让本地模型替你生成。详见测试集构建器指南。
导出结果
点击结果标题栏中的导出按钮,可以把基准测试数据下载为 JSON、CSV 或 Markdown。JSON 包含完整的结构化数据,便于脚本处理与分析;CSV 是扁平的表格数据,适合电子表格;Markdown 则是可直接粘贴进文档的格式化报告。关于全部导出选项以及分享到 GitHub Discussions,详见导出指南。
小贴士
- logprobs 需要
/v1接口 —— 这里用的是 Ollama 的 OpenAI 兼容 API,而不是原生的/api接口。 - 先跑小测试集 —— 先用一个子集估算完整运行需要多久。
- 支持续跑 —— 如果测试中断,可以从中断处继续。
- 对比量化等级 —— 用 Q4 和 Q8 跑同一个模型,看看量化对准确率的影响。